把内部系统包成 MCP Server
AI-FDE 转型之路 · AI 工程 08-MCP开发
一、MCP 不是模型多了个本事,是增加了一个USB扩展
MCP 本身不会让模型聪明。它的全部价值就一句话——将内部系统通过USB方式进行接入。
先说一下由来。MCP 是 2024 年 11 月由 Anthropic 发布并开源的公开规范;2025 年 12 月捐给了 Linux 基金会下的 Agentic AI Foundation(由 Anthropic、Block、OpenAI 共同发起,Google、微软、AWS、Cloudflare、Bloomberg 支持),MCP 是它的创始项目之一。官方给出的体量是:公开可用的 MCP Server 超过 1 万个,SDK 月下载 9700 万次,ChatGPT、Claude、Cursor、Gemini、Microsoft Copilot、VS Code 都已经支持。
捐给基金会这件事对甲乙方有实际意义:标准不再由一家公司说了算,而是要作为一个通用的标准。
定义我给一句人话版:它规定了一套标准说法,让 AI 应用能用同一种方式发现"这边有哪些能力"、调用它们、拿回结果。 技术上它跑在 JSON-RPC 2.0 上,这个细节不用记,你只要知道它是一套消息格式加一套约定,不是某个产品、也不是某个模型的功能。
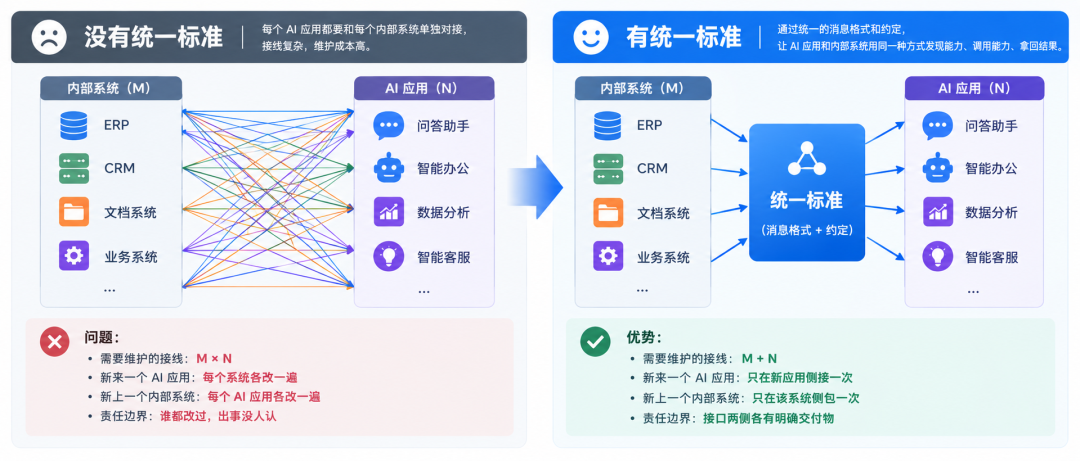
它要解决的问题,是一个乘法。行里有 M 个内部系统、N 个 AI 应用,两两对接是 M×N 条线;有了统一的口子,变成 M+N。
| 看什么 | 没有统一标准 | 有统一标准 |
|---|---|---|
| 要维护的接线 | M × N | M + N |
| 新来一个 AI 应用 | 每个系统各改一遍 | 只在新应用侧接一次 |
| 新上一个内部系统 | 每个 AI 应用各改一遍 | 只在该系统侧包一次 |
| 责任边界 | 谁都改过,出事没人认 | 接口两侧各有明确交付物 |
李工问过我一句,我记到现在:"你们这个问答上线要我配合对接,下一个 AI 应用来是不是还得再来一遍?一年要来几趟?"这个问题的答案,就是这一篇要讲的东西。
二、MCP有三个角色、三样东西
先看角色。规范里的原词是 Host / Client / Server,我按"落到银行是什么"来对:
| 角色 | 规范里的说法 | 落到项目里是什么 |
|---|---|---|
| Host(宿主) | 发起连接的 AI 应用 | 员工用的那个问答界面或助手 |
| Client(客户端) | 宿主内部负责连接的那个组件 | 界面里"连到信贷系统"的那条连接 |
| Server(服务端) | 提供上下文与能力的服务 | 我们包出来的那一层,背后是信贷系统 |
这里有个坎,很多人绕不过来:Server 不等于你行里的老系统。 Server 是贴在老系统外面的一层外衣——老系统一行代码不动,Server 替它说话。所以"包成 MCP Server"这件事,从来不是改造老系统,是给它加一个翻译。
再看 Server 能提供什么。规范里就三样,不多不少:
| 三样东西 | 是什么 | 谁决定用不用 | 恒信银行的例子 |
|---|---|---|---|
| Tools(工具) | 可被调用、会返回结果或产生动作的函数 | 模型自己决定(所以要你写好描述) | 查一笔授信状态、算一次可贷额度 |
| Resources(资源) | 可被读取的数据,像文件、记录 | 应用或用户选,模型不擅自读 | 制度文件、产品目录、客户档案 |
| Prompts(提示词模板) | 预设好的消息模板与工作流 | 用户挑 | "按信贷材料初审口径出一份清单" |
分工要记牢:Tools 是"能动手",Resources 是"能查资料"。 新手最常犯的错是把所有东西都做成 Tool——连制度文件也做成一个"读取制度"的工具,结果模型每次都要先"决定要不要读",既慢又容易乱读。资料就该是 Resource,动作才配当 Tool。
还有一个能力方向值得知道:Server 可以反过来要求补充信息(规范里叫 elicitation,比如"你要查哪个客户"),由客户端去问用户、再把答案带回去。这条在银行场景里其实很有用——它意味着"材料不全就先问,别硬猜"可以做成协议层的动作,而不是靠提示词求模型别瞎编。
三、MCP 和工具调用不是一回事,也不是替代关系
这一节大概是全篇最该讲清的,因为这两个词天天被混着说,混完就会出现"上了 MCP 模型是不是就更会调工具了"这种问题。
工具调用(Tool Calling,也叫 Function Calling)解决的是"模型怎么表达它想调一个函数"。 模型输出一段结构化的参数,宿主去执行,再把结果塞回去(原理在 06 讲的原理里拆过)。这是模型侧的能力,换厂商换模型,机制大同小异。
MCP 解决的是"这些工具从哪来、有哪些、怎么被发现、怎么被调用"。 它管的是供给与连接:Server 声明自己有哪些 Tools / Resources / Prompts,Client 把它们列出来,宿主再转成模型能选的一批工具。
所以真实链路是叠起来的:
业务问题 → Agent 或应用→ 从 MCP Server 拿到能力清单 → 清单按工具调用的格式交给模型 → 模型选一个、给出参数 → 宿主执行(这次执行很可能正打在 MCP Server 上)→ 结果回去 → 继续循环。
一句话收口:MCP 不替模型做决定,它只是把"有什么可调"标准化了。
打个比方。工具调用是点菜的说法——你得说清"一碗牛肉面,不要香菜",后厨才做得对。MCP 是商场里所有餐厅接入外卖平台的统一规格——谁都能接,菜单格式一样,平台不用为每家重写一遍对接。说法是一回事,规格是另一回事;两样都要,但不能互相顶替。
| 看什么 | 工具调用(Tool Calling) | MCP |
|---|---|---|
| 解决的问题 | 模型怎么表达"调什么、带什么参数" | 工具从哪来、有哪些、怎么被调用 |
| 属于哪一层 | 模型 / 推理侧 | 集成 / 连接侧 |
| 谁定义 | 各家模型厂商的接口 | 公开规范,现由基金会托管 |
| 上了它模型会更聪明吗 | 不会,只是能动手 | 不会,只是接入得省事 |
| 不做它行不行 | 不行,模型只能聊天 | 行,但每个应用、每个系统各接一遍 |
| 系列里哪一讲 | 06 讲 | 本篇 |
顺手把 Agent 也塞进这张图,三者一次说清:Agent 是"决定下一步做什么"的那个循环,工具调用是它开口的方式,MCP 是它工具的来源。 这三样可以缺一样——没有 MCP 也能做 Agent,工具写死在代码里就行;但没有工具调用的模型,做不成 Agent。
四、值得包和不该包,差在三个问句上
我的判断是:MCP 的门槛不在"能不能包",在"值不值得包"。 行内多数项目栽在后者——为了技术好看多了一层,还多了一个要长期维护的东西。
按顺序问三句:
有没有第二个调用方,或者明年会不会有。 只有一个 AI 应用、只调一个接口,直接调就完了,包成 MCP 纯属多一层。反过来,如果问答、合同审查、坐席辅助三个应用都可能要查同一个系统,这层立刻值。
这个系统会不会被反复接。 每次接都要重做鉴权、参数转换、返回裁剪的,值得包;接口本身简单、几年只接一次的,不值得。
要不要给别人用。 这套 Server 将来要给别的团队、甚至外部厂商的 AI 用,标准化的收益马上兑现;永远只有自己人用,收益打折。
还有一条反向的:写操作要格外慎重。 查询类包进去风险可控;"提交工单""发起支付""调整额度"这类,一旦包进 MCP,等于把一个能动手的接口交给了一个会犯错的模型。真要做也可以,但下一节那四道关一道都不能省。
我先说我自己被教育过的一次:很早的时候我觉得"什么都包进 MCP 最干净",结果一个只查一张表的小接口也包了一层,上线后每次排查要先看网关、再看 MCP 服务、再看老系统,三跳。多一层,就多一处可能出错、多一处要盯着的地方。 这一层该不该存在,要用上面的三个问句来答,不是用技术偏好来答。
五、包完不算完,四道关过不了就不叫交付
这一篇不指望你能从零写一个服务,那不是这个岗位的活。但标准得落在东西上,所以下一节给你一份真能跑的二十几行。现在先说验收的四条标准(示例清单,按你的项目校准):
它复用的还是新造的。 认证是不是接行内现有体系?答案要是"新建一套账号",在银行客户这里基本过不了审。规范里授权这块给了一整套现成做法,你不用自己发明,但必须问清楚工程师选了哪套。
改一个系统要不要动其他系统。 新增一个能力,是只在这一个 Server 里加,还是所有 AI 应用跟着改。前者才叫中间层,后者只是把耦合换了个地方。
调用有没有留下痕迹。 谁、什么时候、调了什么、带什么参数、结果如何——要落进客户既有的审计体系,不是只躺在应用日志里。审计统一入口那件事,第 14 讲讲 AI Gateway 时会再撞上。
能不能一键关掉。 出事时有没有一个开关立刻停掉它对内部系统的调用,且不影响其他业务。这条在金融客户这里是硬要求,出事的时候能救命。
再加一条给会和工程师对话的人,很关键:Server 说自己"只读",不等于它真的只读。 规范里确实有标注工具行为的字段,但那是服务端自己填的,规范原文明确提醒——工具的描述这类信息,在来源不可信时应当按不可信处理。同理,规范把"调用工具前必须取得用户明示同意"写成了原则,可它自己也承认,这些安全原则在协议层面无法强制,只能靠实现方自觉。这句话翻译成甲方语境就是:别信声明,要看实现和审计。 这也是为什么上面那四道关里,第三关比第一关更难糊弄。
动手任务:挑一个你最常对接的行内系统,画一张"现在 AI 怎么调它"的连线图,标出鉴权、转换、日志各做在哪。然后回答两个问题——如果再加一个 AI 应用,图上有几根线要重画?如果要把它包成 MCP Server,上面四道关里哪一道会最先卡住?
六、真家伙就二十几行,你要看得懂四件事
先把一个坑说在前面:官方 Python SDK 已经到 v2,类名是 MCPServer。而网上大量教程还是 v1 的 FastMCP 写法——照着抄,报错会从第一行开始。这正好印证了第七节那条坑:版本必须落在纸上,不能落在"网上都说"上。MCP server和client版本要注意一下,建议保持一致,有时候他们依赖其他包的版本,过了快速发展期应该都会稳定下来。
下面这份是完整可用的:
from mcp.server import MCPServer
from mcp.server.mcpserver.exceptions import ToolError

mcp = MCPServer("信贷查询", instructions="只读查询,不修改任何数据。")

_DB = {                                            # ① 数据从哪来
    "C001": {"name": "恒信机械制造", "limit": 800.0, "used": 620.0},
    "C002": {"name": "恒信建材", "limit": 300.0, "used": 285.0},
}

@mcp.tool()                                        # ② 声明:这是一个工具
def query_credit(customer_id: str) -> dict:
    """按客户号查询授信总额与已用额度。只读,不修改任何数据。

    customer_id:客户号,例如 C001。
    """
    row = _DB.get(customer_id)
    if row is None:                                # ③ 失败怎么说
        raise ToolError(f"客户号 {customer_id} 不存在")
    return {"customer_id": customer_id, **row,
            "available": row["limit"] - row["used"]}

if __name__ == "__main__":
    mcp.run()                                      # ④ 怎么跑:默认 stdio
四件事,就是你要看得懂、也要问得出来的四件事:
| 位置 | 代码里是什么 | 你该问工程师什么 |
|---|---|---|
| ① 数据从哪来 | 现在是假数据,真实项目里换成对老系统的调用 | 走的是哪个账号?超时多少?取不到的字段怎么返回 |
| ② 声明 | @mcp.tool() 加一个函数 |
这个工具的说明写清楚了吗——""" 里那段就是第 06 讲那份"说明书",一字不改地给到模型 |
| ③ 失败怎么说 | raise ToolError(...),不是 return "查询失败" |
失败是"抛出来",还是被 try 吞掉伪装成成功?这一条直接决定审计能不能查出问题 |
| ④ 怎么跑 | mcp.run() 默认 stdio |
内网多人用要改成 Streamable HTTP;端口、证书、网关谁批 |
第 ② 条值得多说一句,因为它是这一篇和第 06 讲真正咬上的地方。你写的那段函数说明,就是模型看到的一切。 实测这个服务端被列出来时是这样的:
工具名: query_credit
描述:   按客户号查询授信总额与已用额度。只读,不修改任何数据。
参数:   {"properties": {"customer_id": {"type": "string"}}, "required": ["customer_id"]}
参数表不是谁手工写的,是从 customer_id: str 这个标注自动生成的。所以"能不能被正确调用",一半取决于这段说明写得准不准——写得含糊,模型乱调;写清"只读",它才不会拿它去当改数据的用。 反过来,说明里撒谎(明明会写库却说只读),就正好撞在第五节那条「别信声明」上。
安装就一句 pip install "mcp[cli]"。内网机器回到 07 讲那套离线打包,先把轮子带进去,别到客户机房才发现装不上。
跑起来的两条路,按现场条件选:
有 Node 环境:
mcp dev server.py,它会拉起一个网页版 Inspector,点开就能看见工具清单、填参数、看返回。这是最直观的验收方式,演示给客户看也体面。内网没有 Node:自己写十几行客户端当调用方(
from mcp import Client, StdioServerParameters,async with Client(...)里list_tools()和call_tool())。我用这种方式验过两件事:正常调用返回结构化数据;故意传一个不存在的客户号,结果是is_error=True加一句错误说明,而不是把客户端整崩——工具报错不该炸掉宿主,这条要专门测一次。
七、坑
把 stdio 当成"部署在服务器上"。 这是现场最容易出的事故:stdio 的 Server 是宿主在本机拉起的一个子进程,跟着那台电脑生死。有人拿它当共享服务装在应用服务器上,第二天发现全行都连不上——因为没有任何一台"本机"在跑它。要多人共用,就得走 Streamable HTTP(一个 HTTP 端点那种),并且把端口、证书、网关一起规划。传输方式选错,是这一块最常见的返工。 顺带一条纪律:stdio 下 stdout 就是那根线。 v2 的 SDK 会把服务期间打出去的 stdout 改道到 stderr,但服务启动之前的输出、以及憋到进程退出才排空的 print(),仍然会落到线上,宿主那边表现成"消息解析失败、服务没反应"。所以日志一律用 logging,不要用 print。
版本没对齐就开工。 MCP 到 2026 年 7 月已经出到第五个版本:2024-11-05 → 2025-03-26 → 2025-06-18 → 2025-11-25 → 2026-07-28,而且改得不轻。举个能感知的例子:2026-07-28 这一版把 initialize 握手整个取消了,改成每条请求自己带上版本与能力;老的 HTTP+SSE 传输,以及 Roots、Sampling、Logging 三个特性,都被列进弃用清单(官方给了最短 12 个月的弃用窗口)。所以合同或方案里必须写清"按哪个版本实现"。两边各按不同版本做一半,联调时会互相认不出来,而这种错在测试环境往往不暴露。
拿一个超级账号跑 Server。 图省事用一个高权限账号,等于把行内权限体系整个绕过去——日志里全是它,查不出是谁干的。正确做法是把调用人的身份透传下去,让老系统按它自己的规则再判一次。认证的复用,说的就是这件事。
一次把几十个能力全包进去。 我更愿意先包一个:最有代表性、调用最频繁的那一两个,跑通再扩。一次铺太大,测试、权限评审、文档的量会把人压垮。顺带一句,工具一多模型选错的概率也往上走(06 讲那条"同一决策层别超十个"的红线,在这里照样管用)。
回到李工那句话:下一个 AI 应用来,还要不要再对接一遍。有了这一层,答案是"系统不用重接,改接这一层";但这句答案能不能站住,取决于四件事——它复用了谁的权限、影响面有多大、关掉会停掉哪些调用、按哪个版本实现。这四句说得清楚,你才叫能验收,而不是只能在验收单上签字。
《AI-FDE 转型之路》:写给不写代码的 IT 实施 / 售前 / 运维,把已有的交付能力「AI 化」。全系列 55 篇,六大模块 53 项技能。
想先看看自己缺什么:AI-FDE 技能自评地图,53 项打分,出一张雷达图。AI-FDE 转型之路 · 开篇