Context-Engineering:大模型到底看得见什么
AI-FDE 转型之路 · AI 工程 03-Context-Engineering
一、Context是什么
Context是上下文,上下文怎么理解呢,学过技术的人比较懂,没有学过技术人还挺难理解,也可以称为语境。
这个语境又怎么理解呢。例如小王和小明在聊天,小王讲了一个笑话,小明听到后哈哈大笑。小亮看到后很好奇,然后问他们为什么笑,小王将笑话的前因后果告诉了小亮,小亮也笑起来了。他们之间聊天的内容就是Context,就是上下文。
二、Prompt与Context的关系
Prompt是提示词,一般说Prompt就是一次输出的内容,如果对到人类身上,就是一次交互的内容(小王给小明说了一段话)。Prompt是Context里面的一次交互内容,可以是一句话,也可以是一段话。
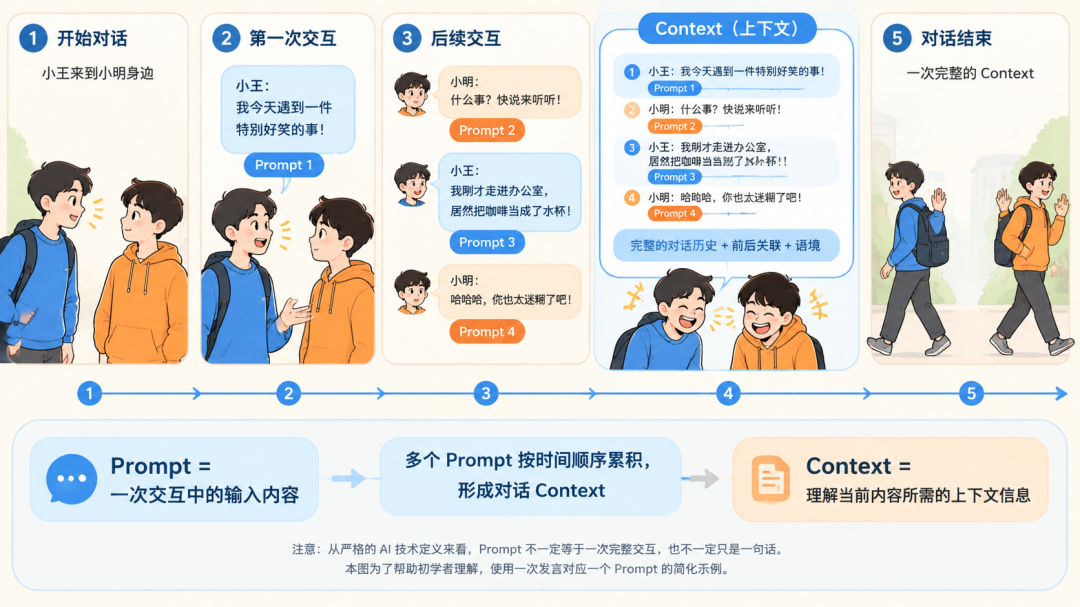
Context的真正形成从②开始,就是第一句话开始,经过③和④积累增加语境,⑤结束对话,两个人离开。
人类与大模型对话不同点:人有记忆,而大模型是没有记忆的,你给AI说什么话,它就只记得你现在给它说的这句话。
三、Context与大模型
刚刚说了,大模型只记得你刚刚说的话,大模型没有自动延续的聊天记忆功能。那怎么与大模型进行多次交互呢,DeepSeek的聊天是怎么做到的呢?不能只问一句,它回答一句就完事了吧。
是这样的,你说第二句的话时候,程序将“你的第一句话内容”+“大模型第一次回答的内容”+“你的第二句话内容”全部发送给大模型。
那第三句话的时候呢?程序将“你的第一句话内容”+“大模型第一次回答的内容”+“你的第二句话内容”+“大模型第二次回答的内容”+“你的第三句话内容”都发送给大模型。
第四、五、六、N都是这样,1到N句话和大模型回答的内容这些就是Context。看下面的图不知道是否可以更好的理解Context上下文。
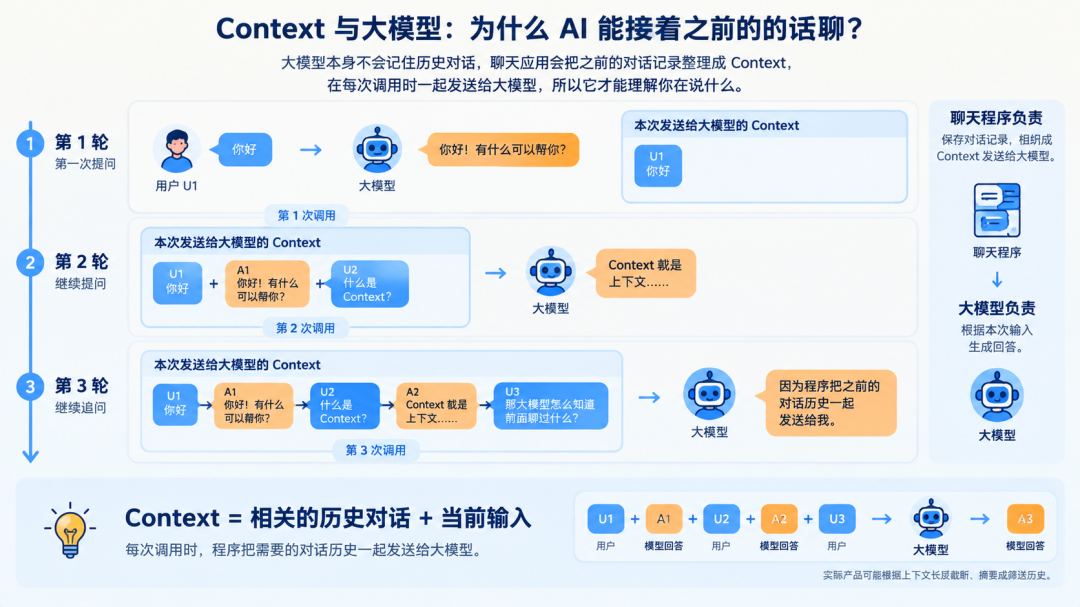
每次与大模型交互的时候,都会将之前的聊天信息发送给大模型,大模型才能知道聊天的信息,类似滚雪球似的,越滚越大。大模型的上下文有没有上限呢,这个肯定是有的。例如:DeepSeek 官方资料显示,截至 2026 年 10 月。
| 模型 | 最大上下文窗口 | 最大输出长度 |
|---|---|---|
| DeepSeek-V4-Pro | 1,048,576 Tokens(约 1M) | 393,216 Tokens |
| DeepSeek-V4-Flash | 1,048,576 Tokens(约 1M) | 393,216 Tokens |
那问题来了,Token又是什么呢。
Token 是大模型处理文本时使用的基本单位。一个汉字可能对应一个或多个 Token;一个英文单词也可能被拆成多个 Token。 这个根据什么来拆分呢,一个英文单子也要拆分吗。这个是由大模型使用的分词器(Tokenizer)及其词表决定的。
雪球越滚越大,如果超过最大上下文窗口怎么办呢。如果真的超过了,大模型就没有办法处理了,就报错歇菜了。
四、会话压缩
在产品设计时,都会设计上下文的大小,不会超过大模型最大的上下文窗口。当交互对话将要超过产品设计的阀值时,程序会对大模型的会话进行压缩,让大模型总结之前Context的内容,提取成为摘要,这样摘要变成了Context,Context的体积就减少了。
除了压缩,还有很多 减少Context 体积的方法
1)截断(Truncation)
超过设定的范围,就丢弃最早的对话。
例子:只保留最近 200 条消息,新消息进入后,删除最早的消息。
2)历史筛选(History Filtering)
根据规则或相关性,挑选与当前问题有关的历史信息。
例子:用户询问数据库选型时,只保留之前讨论数据库的内容。
3)检索(Retrieval)
把历史信息存储起来,需要时再查找,而不是每次都全部发送给模型。
例子:用户询问“之前确定的数据库是什么?”,程序从历史记录中找出相关内容。
4)摘要与状态提取(Summarization / State Extraction)
将大量对话整理成简短的关键信息。
例子:把多轮讨论总结为“技术栈:Spring Boot + MySQL;当前任务:优化查询性能”。
5)分层记忆(Hierarchical Memory)
将信息分层保存,根据需要使用不同层级的内容。
例子:最近的对话放在当前上下文中,项目的重要决定单独保存,旧资料需要时再检索。
6)滑动窗口(Sliding Window)
只保留最近一段对话,新内容进入后,旧内容逐渐移出。
例子:始终保留最近 10 轮对话。它可以看作截断的一种实现方式。
7)Token 预算分配(Token Budgeting)
给不同内容分配 Token 额度,避免某一部分占用过多空间。
例子:限制检索资料的长度,为当前问题和模型回答预留空间。
8)外部记忆与持久化存储(External Memory)
将重要信息保存到数据库或文件中,需要时再取出来使用。
例子:把项目的技术栈、业务规则和关键决定保存起来,后续对话中按需读取。
五、大模型的幻觉
当你的Context越来越大时,Context描述的信息越来越多,大模型读取没有规则的数据时,可能就找不到重点了。东描述一点,西描述一点,大模型就开始产生幻觉,这是大模型产生幻觉的原因之一。
当你的Context越来越大时,你启动了大模型压缩会话功能,将大量的内容精简一小段会话,你感觉精简的数据能保证原来的意思吗,是不是这一块大模型有出现了幻觉,这也是大模型产生幻觉的原因之一。
因此,上下文管理不当和会话压缩失真,都可能增加大模型产生错误答案或幻觉的风险。
六、大模型的记忆
记忆(Memory),前面我们说了,Context 是大模型本次回答时能够看到的信息。但如果每次都把所有历史对话发送给大模型,不仅会占用大量 Token,还需要将之前每一次对话发送给大模型,这样才能记住之前的内容。
那么问题来了:如果不把所有历史对话都放进 Context,大模型怎么记住以前的信息呢?
这就涉及记忆(Memory)。
例如,你在一次对话中告诉 AI:“我正在开发一个 Spring Boot 项目,数据库使用 MySQL,JDK 版本是 17。”
过了几天,你重新开启一个会话,询问:“帮我优化一下这个项目的查询性能。”
如果 AI 能够记住之前的项目背景,就可以直接基于这些信息回答,而不必让你重新介绍一遍。
那么,这些信息是怎么保存的?
在实际应用中,记忆通常不是大模型自动永久保存所有对话,而是由应用程序将重要信息提取出来,保存到历史记录、数据库或其他存储中。可以是一个MD文件、一个JSON文件,一些数据库数据。
当后续对话需要这些信息时,再将它们取出来,放入当前的 Context,发送给大模型。
例如,你使用的workbuddy就会记录你的记忆,就算打开新的任务,它都会将你的个人喜好连同问题一起发送给大模型,这样就减少时间成本。
七、什么叫Context-Engineering(上下文工程)
阅读前面的内容后,你可能会发现,上下文管理并不只是把聊天记录发送给大模型那么简单。
我们需要考虑:哪些信息应该保留,哪些信息应该删除,历史对话如何压缩,记忆如何保存,以及什么时候需要从知识库中检索信息。
如果这些工作没有做好,即使使用能力很强的大模型,也可能因为缺少关键信息、上下文混乱或历史信息失真,给出错误的答案。
因此,我们需要把这些工作当作一项工程来设计,这就是 Context Engineering(上下文工程)。
在实际应用中,上下文工程通常需要考虑以下几个方面:
信息来源: 系统指令、用户输入、历史对话、记忆、知识库和工具执行结果。
信息筛选: 判断哪些信息与当前任务有关,避免无关内容干扰模型。
信息管理: 对历史对话进行截断、摘要和压缩,控制 Context 的体积。
信息检索: 在需要时,从知识库、数据库或历史记录中获取相关信息。
上下文组装: 将筛选后的信息合理组织起来,再发送给大模型。
而且上下文工程在 RAG 和 Agent 产品设计中尤其重要,会直接影响产品的质量。
大模型决定了模型能够做什么,而上下文工程在很大程度上决定了它在具体任务中能否获得正确的信息,并把能力发挥出来。
八、上下文都是钱
输入和输出都按 Token 计费,而且每次请求都要把整段上下文重新带上去。一段五千 Token 的系统提示词,一万次调用就是五千万 Token。这笔钱单个阶段看不出来,等上量之后,账单的金额是最扎眼的一行。随着算力的增加,这部分开销应该会越来越便宜了,像流量一样便宜。
《AI-FDE 转型之路》:写给不写代码的 IT 实施 / 售前 / 运维,把已有的交付能力「AI 化」。全系列 55 篇,六大模块 53 项技能。
想先看看自己缺什么:AI-FDE 技能自评地图,53 项打分,出一张雷达图。AI-FDE 转型之路 · 开篇